GeoScore 2.4.5 : un outil de webmaster pour découvrir ce qui manque vraiment à son site
前往评论 ↓GeoScore 2.4.5 : un outil de webmaster pour découvrir ce qui manque vraiment à son site
Pourquoi cet outil a été créé
L’ancienne version de GeoScore était un projet déjà développé par quelqu’un d’autre, https://geoscoreapp.pages.dev/, où l’on peut aussi l’essayer. J’ai essayé d’utiliser cet outil pour optimiser continuellement le SEO de mon site, en ajoutant même des listes de type wiki pour Amiya’s Desk et Amiya_desi afin d’améliorer le GEO, le SEO, etc.
Cependant, ce projet a fini par montrer ses limites. Mon blog personnel recevait souvent des suggestions d’ajout de FAQ, de grilles tarifaires ou de schémas de service, alors que mon site ne propose ni forfaits ni prestations.
Heureusement, je ne manque pas de crédits IA. Puisque j’en avais besoin, autant me lancer dans un fork et continuer à le développer ! Cette fois, il fallait impérativement bien gérer les catégories : pour un blog personnel, ce genre de FAQ, de grille tarifaire et de schéma de service n’est vraiment pas nécessaire.
GeoScore a donc été développé à partir du projet original https://github.com/sprawf/geoscore. Le GeoScore d’origine étant sous licence MIT, j’ai choisi de conserver cette licence.
Il s’agit d’un outil d’audit SEO et GEO open source sous licence MIT, dont le point d’entrée et le code source sont disponibles ici :
https://github.com/Amiyadesi/geoscore
La documentation complète d’utilisation en chinois et en anglais se trouve ici :
Son rôle est de séparer les problèmes découverts, les problèmes encore inconnus et les règles totalement inapplicables, de laisser aux webmasters des pistes de modification vérifiables, et de générer des conclusions de modification sous forme de document Markdown à fournir à une IA pour un renforcement ciblé.
Dans la version 2.4.5, l’essentiel reste de distinguer les conclusions des suppositions
Chaque vérification factuelle possède uniquement cinq états :
| Statut | Signification |
|---|---|
pass | Confirmé comme validé depuis la page ou la réponse |
fail | Preuve claire qu’une action est requise |
not_applicable | Cette règle ne s’applique pas au site ou à la page actuelle |
unknown | Pas assez de preuves pour juger actuellement |
error | Problème de scraping ou de service externe |
Seuls les statuts pass et fail jugés applicables et concluants comptent pour le score factuel.
unknown et error ne sont pas convertis en échecs, mais ils réduisent la couverture (coverage) et la confiance (confidence).
Lorsqu’il y a trop peu de preuves, GeoScore préfère indiquer que les preuves sont insuffisantes, ce qui montre en soi qu’il y a de nombreuses lacunes dans ce domaine.
La version 2.4 introduit un mécanisme de plafonnement pour les échecs graves.
Un échec critique (critical) plafonne le score maximum de la catégorie correspondante à 49, et chaque échec critique supplémentaire retire 10 points de plus, jusqu’à un minimum de 19.
Un échec majeur (major) plafonne le plafond à 79, et chaque échec majeur supplémentaire retire 10 points de plus, jusqu’à un minimum de 49.
L’impact des échecs mineurs (minor) est plus léger, mais ils ne peuvent pas non plus être totalement ignorés.
Cette règle vise à empêcher qu’un site problématique, bloqué par noindex, impossible à scraper ou dont le texte principal est inaccessible, obtienne un rapport faussement rassurant avec une note élevée simplement parce que les attributs alt des images et les balises Open Graph sont bien faits.
C’est pourquoi l’ordre dans lequel je consulte les résultats est très strict : d’abord les échecs graves et les preuves, ensuite la couverture et la confiance, et enfin seulement le score total.
Comment 73 sites réels participent à l’étalonnage
Je ne voulais pas me contenter de mon propre blog pour prouver que la catégorisation est exacte ; je maintiens donc désormais une matrice d’étalonnage de 73 types de sites.
On y trouve des sites d’actualité, des blogs personnels, des portfolios, des sites de documentation, des projets open source, de l’e-commerce, des communautés, du SaaS, des services professionnels, des entreprises locales, des organisations à but non lucratif, des sites gouvernementaux et des sites universitaires.
Pour chaque site, on définit d’abord la plage de types acceptables, puis le code actuel effectue le scraping et l’évaluation de manière autonome.
Les deux dernières exécutions ont donné respectivement 48 correspondances, 0 vérification humaine requise, 25 indisponibles, et 47 correspondances, 0 vérification humaine requise, 26 indisponibles.
La différence d’un site entre les deux résultats est due à la disponibilité réelle du réseau, et non à l’apparition d’un nouveau conflit de classification.
Tous les échantillons ayant réussi le scraping et l’évaluation se trouvent dans la plage de types autorisée au préalable.
L’indisponibilité provient généralement d’un pare-feu WAF, de restrictions géographiques, d’erreurs réseau ou de pages de vérification ; cela ne signifie ni que la classification a réussi, ni qu’elle a échoué.
Ces 25 sites sont conservés dans la matrice, car ce sont précisément ces pages récalcitrantes que les outils d’audit doivent affronter.
Les scores en tant que tels sont étalonnés séparément à l’aide de fixtures HTML étalons.
Les blogs personnels, les SaaS, l’e-commerce, les entreprises locales, les médias et les sites inconnus disposent de plages de preuves et de scores fixes, et le plafonnement en cas d’échec grave fait l’objet de tests de régression indépendants.
La matrice de sites réels sert à détecter les biais de classification, tandis que les fixtures étalons garantissent la reproductibilité des variations de score ; on ne peut pas mélanger ces deux aspects pour en faire un unique taux de réussite flatteur.
Mode site et mode URL unique
GeoScore s’utilise de deux manières.
Saisir un nom de domaine active le mode site, qui extrait au maximum cinq pages HTML représentatives.
La page d’accueil est lue en premier ; si une page “À propos” est détectée, elle est ajoutée, puis d’autres échantillons sont sélectionnés par type de chemin d’accès à partir du sitemap ou des liens internes de la page d’accueil.
Cinq pages ne constituent pas un robot d’exploration complet du site, cela permet simplement de maintenir l’audit dans un périmètre explicable et reproductible.
C’est pourquoi la liste des échantillons dans le rapport mérite d’être consultée : elle vous indique de quelles pages proviennent réellement les conclusions de cette session.
Si je souhaite uniquement vérifier un nouvel article, une page de destination tout juste modifiée ou une page thématique spécifique, je peux coller l’URL complète.
Cela active le mode URL unique, qui se concentre sur la page cible.
Lorsque la page cible n’est pas la page d’accueil, l’outil lit tout de même la page d’accueil si nécessaire pour établir un contexte, évitant ainsi de traiter l’ensemble du site comme un SaaS sur la seule base d’un article traitant de l’IA.
En général, je commence par lancer le domaine pour valider la configuration publique globale et le profilage du site, puis j’exécute le mode URL unique sur les pages que je souhaite réellement modifier.
D’abord, vérifier pour quel type de site l’outil vous a pris
Une fois l’audit terminé, ne vous jetez pas immédiatement sur le score total.
Regardez d’abord le profil du site :
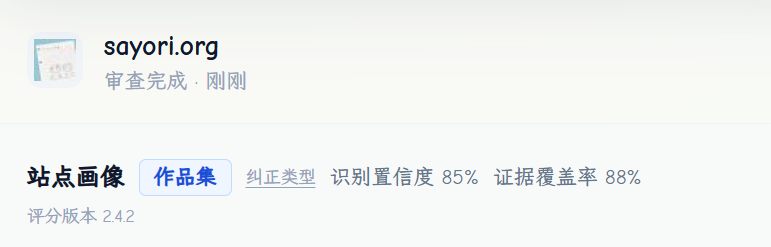
S’y affichent le type de site, l’entité, la langue, le domaine racine, les pages échantillonnées, la confiance de reconnaissance et les preuves de classification.
Le profil s’appuie en priorité sur le JSON-LD, la balise canonical, le titre, la navigation et la structure de la page ; les mots-clés du texte principal ne doivent être considérés que comme des indices faibles.
Cela évite qu’un blog personnel ne soit jugé comme un SaaS, un site de documentation comme un site e-commerce, ou qu’un site d’articles ne se voie imposer de force un schéma commercial.
Si le type est effectivement erroné, vous pouvez fournir un indice de type uniquement pour cet audit en cliquant sur “Corriger le type” pour sélectionner le bon.
Cela ne revient pas à écrire une règle permanente pour l’ensemble du système, et cela n’affecte pas les autres sites.
Pourquoi est-il impossible de continuer les calculs par force brute lorsqu’une page est inaccessible
Les sites web réels renvoient souvent autre chose que le texte principal directement.
Certains sites affichent un défi Cloudflare, d’autres une page de connexion ou de consentement, et SiteGround peut également renvoyer une page de vérification /.well-known/sgcaptcha/ via une réponse HTTP 202.
Ces pages ressemblent également à du HTML, mais les utiliser pour un audit SEO ne donnerait qu’un faux rapport sur une page de vérification.
La version 2.4.5 identifie d’abord ces pages intermédiaires et ne traite plus les réponses HTTP 202 ou les pages de vérification vides comme des réussites de scraping.
Lorsqu’une vérification HTTP ordinaire se heurte à un défi, à une erreur réseau renouvelable ou à une coquille vide en JavaScript, la page d’accueil peut utiliser une tentative de secours via Cloudflare Browser Run.
Cette tentative dispose d’un budget strict de 20 secondes.
La navigation sur la page utilise un maximum de 16,5 secondes, puis 1,5 seconde supplémentaire après l’événement load pour achever l’hydratation classique, et enfin 2 secondes sont réservées pour récupérer le HTML.
Auparavant, lors de l’utilisation de networkidle2, les scripts d’analyse et les requêtes continues pouvaient empêcher la page d’atteindre l’inactivité du réseau, épuisant finalement tout le budget.
Désormais, on n’attend plus que le réseau en arrière-plan soit totalement calme, mais on vérifie tout de même si le résultat du rendu correspond à un défi, à une page d’erreur ou à une coquille JavaScript sans texte principal.
Si la solution de secours échoue également, GeoScore laisse la page à l’état unknown ou error, et le score total peut directement passer à un statut de preuves insuffisantes.
La version 2.4.5 pousse par ailleurs le cache d’audit à v24.
Ainsi, après le déploiement, les résultats de délai d’attente (timeout) ou de page de vérification laissés par l’ancienne version ne seront plus atteints, et l’ancien cache expirera naturellement selon son TTL d’origine.
Comment utiliser une API personnalisée
Sous le champ de saisie de la page d’accueil se trouve un panneau d’API personnalisée replié par défaut.
Il s’agit d’une fonctionnalité optionnelle, utilisée uniquement une fois l’audit factuel terminé pour effectuer une observation des réponses destinées à l’Evidence Map.
En renseignant la clé API (API Key), l’URL de base HTTPS (HTTPS Base URL) et le modèle (model), vous pouvez récupérer la liste des modèles ou saisir directement un modèle connu à la main.
L’URL de base n’a pas besoin de comporter /v1/models ajouté manuellement.
Si je saisis https://api.example.com, GeoScore complétera automatiquement par https://api.example.com/v1.
Si l’on colle par mégarde /models ou /chat/completions en même temps, l’outil reviendra d’abord au chemin racine de l’API correspondante avant d’émettre la requête.
Ces trois champs doivent être remplis ensemble ; s’il en manque un seul, la requête ne peut pas être envoyée.
Avant de lancer l’audit, le navigateur les efface ; ils ne sont pas écrits dans le stockage du navigateur, dans l’URL ou dans le rapport téléchargé.
Côté serveur, ils sont également traités uniquement comme la configuration d’une seule requête et ne sont pas persistants une fois l’audit terminé.
Cela ne signifie pas pour autant qu’il est prudent d’afficher une vraie clé lors d’un enregistrement d’écran ou d’un direct ; les informations sensibles doivent toujours être masquées.
Une fois la requête terminée, la dernière réponse de l’API s’affiche directement en haut de l’Evidence Map.
On y trouve la requête, le modèle, l’état, l’heure, la durée, le corps de la réponse et le nombre de citations ; il est possible de développer la réponse complète et ses citations.
Le succès ou l’échec de l’API personnalisée ne modifie en rien le score factuel.
Je préfère garder cette option pour la fin, une fois qu’une première série de problèmes factuels a déjà été traitée.
À quoi sert réellement le jeton de surveillance (Token) ?
Une fois un projet de surveillance créé, on obtient deux éléments : un identifiant de projet (project ID) et un jeton de gestion (management token).
L’identifiant de projet sert à identifier le projet, et le jeton prouve que vous êtes autorisé à lire le projet, à modifier les requêtes, à exécuter des instantanés, à consulter l’historique, à renouveler le jeton ou à supprimer le projet.
Le serveur ne conserve qu’un hachage protégé, et le jeton d’origine n’est affiché qu’une seule fois lors de sa création ou de son renouvellement.
Il faut donc le copier d’abord dans son gestionnaire de mots de passe dès sa première obtention.
En cas de changement de navigateur ou d’appareil, on peut saisir l’identifiant de projet et le jeton dans “Associer un projet de surveillance existant” pour recharger les requêtes, l’historique et l’état du projet.
Par défaut, la page ne sauvegarde pas le jeton.
Ce n’est qu’en cliquant explicitement sur l’enregistrement sur cet appareil qu’il est stocké dans le stockage local du navigateur, et il est possible de l’oublier à tout moment en cliquant sur effacer l’appareil.
Si le jeton apparaît dans une capture d’écran, un historique de discussion ou un journal public, renouvelez-le immédiatement : l’ancien jeton expirera sur-le-champ.
La page Docs fournit des requêtes curl et des descriptions d’API publiques prêtes à être copiées.
Comment fonctionne la surveillance par e-mail ?
Pour les projets de surveillance, il est possible de renseigner une adresse e-mail et de valider celle-ci.
Le système n’essaiera d’envoyer des alertes que si une base de référence comparable a été établie, que la version du score est identique, que la couverture est suffisante et que le score a réellement changé.
Lors de la première exécution, en cas de modification de la version du score ou si les preuves sont insuffisantes, le système se contente d’enregistrer l’instantané sans déclencher d’alerte de hausse ou de baisse.
L’adaptateur de messagerie actuel utilise en priorité le canal d’envoi principal ; en cas de défaillance de l’authentification, de limitation de débit (rate limiting), de panne réseau ou de problème en amont, il est possible de basculer vers le service d’envoi fixe propre au webmaster.
Quel que soit le succès de l’e-mail, l’instantané de l’audit déjà réalisé est sauvegardé au préalable.
Télécharger le rapport de correction Markdown complet
Une fois l’audit terminé, vous pouvez télécharger d’un seul coup le rapport de correction Markdown complet, sans avoir à générer les fichiers un par un.
Le rapport intègre le profil du site, les pages échantillonnées, les notes et les causes de plafonnement, l’ensemble des preuves d’échec, les erreurs inconnues et externes, l’état des modules optionnels, les tâches de correction groupées et les étapes de revérification.
À la fin du rapport se trouve également une section contenant un handoff prompt destiné à l’IA de développement.
Elle peut être transmise à Codex, Claude ou d’autres assistants de programmation, mais elle impose à l’modèle de n’utiliser que les preuves existantes, sans inventer de prix, de services, d’adresses, d’entités, d’auteurs ou de sources statistiques inexistants.
Je place généralement ce fichier Markdown à côté du dépôt de code du site, afin que l’assistant de programmation commence par localiser le fichier source correspondant à l’URL, avant de vérifier lui-même le diff.
Une séquence d’utilisation pratique
- Ouvrir https://geo.sayori.org,先用站点模式审首页域名>
- Vérifier que le profil du site et les pages échantillonnées ne partent pas dans la mauvaise direction.
- Si l’écran d’accueil indique un échec de scraping, examiner d’abord les preuves d’obtention de la page, sans chercher à interpréter un score inexistant.
- Consulter la couverture (coverage), la confiance (confidence) et les trois actions prioritaires avant de déterminer si le score total a une valeur de référence.
- Traiter d’abord les échecs critiques (critical) et majeurs (major), en retournant modifier le fichier source ou le modèle CMS de la page correspondante.
- Vérifier séparément pour les problèmes de performance que les données PageSpeed sont réelles tant sur mobile que sur bureau.
- Une fois les problèmes factuels résolus, exécuter l’Evidence Map selon les besoins ou remplir une API personnalisée.
- Télécharger le rapport Markdown et le confier à l’IA de développement pour une seconde passe de localisation, puis valider soi-même les modifications avant le déploiement.
- Créer un projet de surveillance si un suivi continu est nécessaire, et sauvegarder l’identifiant de projet et le jeton dans le gestionnaire de mots de passe.
- Ouvrir https://geo.sayori.org/docs> en cas de doute sur un bouton ou une interface.
- Relancer l’audit de la même URL après le déploiement pour confirmer que les preuves d’échec ont réellement disparu.
Ce que l’outil ne peut pas faire
GeoScore n’est pas un robot d’exploration à profondeur illimitée ; cinq pages d’échantillons ne peuvent pas représenter chaque URL.
Il ne remplacera pas non plus la Search Console, les journaux de serveur, les données utilisateurs réelles ou le jugement de contenu humain.
Pour les pages bloquées par un pare-feu WAF, un mur de connexion, une page de vérification ou des restrictions géographiques, le rapport ne pourra peut-être fournir que unknown ou error.
Dans ce cas, il ne faut pas désactiver les politiques de sécurité simplement pour grapiller des points.
L’outil est encore moins capable de confirmer de manière magique qu’une IA grand public a réellement cité votre site.
À mes yeux, ces limites rendent le rapport d’autant plus exploitable.
Un outil d’audit doit clairement indiquer ce qu’il sait et ce qu’il ignore, et laisser le reste à la vérification du responsable du site.
Pour aller plus loin
Si vous n’avez pas encore de site, vous pouvez commencer par un modèle de blog minimaliste ; le nom de domaine, l’hébergement et le stockage des images peuvent être hébergés sur la formule gratuite de Cloudflare.
Au-delà du scraping et de l’indexation, j’ajuste également l’expérience de lecture réelle des articles ; le processus de choix et de compromis est consigné dans l’historique des refontes du style du blog.