GeoScore 2.4.5: Ein Tool für Website-Betreiber, um herauszufinden, was der eigenen Seite wirklich fehlt
前往评论 ↓GeoScore 2.4.5: Ein Tool für Website-Betreiber, um herauszufinden, was der eigenen Seite wirklich fehlt
Zuerst zum Grund für die Entwicklung
Die ältere Version von geoscore war ein bereits von jemand anderem entwickeltes Projekt, https://geoscoreapp.pages.dev/, hier kann man es auch mal ausprobieren. Ich habe damit ebenfalls versucht, das SEO meiner eigenen Website laufend zu optimieren, und habe sogar die Wiki-Listen Amiya’s Desk und Amiya_desi hinzugefügt, um GEO, SEO und dergleichen zu stärken.
Allerdings zeigte das Projekt mit der Zeit auch seine Grenzen: Mein persönlicher Blog bekam ständig Vorschläge, doch bitte FAQs, Preistabellen oder Service-Schemas einzubauen – dabei hat meine Seite weder Tarife noch nehme ich Aufträge an.
Da mir sowieso nicht das KI-Kontingent ausgeht und ich selbst den Bedarf hatte, dachte ich mir: Entwickle ich es eben als Fork weiter. Diesmal wollte ich die Kategorisierung unbedingt sauber hinbekommen, denn für einen persönlichen Blog sind solche FAQ-Preistabellen und Service-Schemas nun wirklich überflüssig.
GeoScore wurde genau auf Basis des Projekts vom ursprünglichen Autor weiterentwickelt, https://github.com/sprawf/geoscore. Das ursprüngliche GeoScore steht unter der MIT-Lizenz, also habe ich diese ebenfalls übernommen.
Es ist ein Open-Source-SEO- und GEO-Audit-Tool unter MIT-Lizenz – Einstieg und Quellcode finden sich hier:
https://github.com/Amiyadesi/geoscore
Die vollständige Dokumentation auf Chinesisch und Englisch gibt es hier:
Seine Aufgabe besteht darin, bereits gefundene Probleme, noch unbekannte Punkte und schlicht nicht zutreffende Regeln sauber zu trennen, dem Website-Betreiber nachprüfbare Änderungspfade an die Hand zu geben und aus den Ergebnissen ein Markdown-Dokument zu erzeugen, mit dem man eine KI gezielt für Verbesserungen füttern kann.
Der Kern von 2.4.5: Erst Fakten und Vermutungen trennen
Jede Faktenprüfung kennt nur fünf Zustände:
| Status | Bedeutung |
|---|---|
pass | Anhand der Seite oder Antwort bestätigt bestanden |
fail | Eindeutige Belege zeigen Handlungsbedarf |
not_applicable | Diese Regel passt nicht zur aktuellen Website oder Seite |
unknown | Derzeit liegen nicht genug Belege für eine Bewertung vor |
error | Beim Abruf oder einem externen Dienst ist ein Fehler aufgetreten |
Nur pass und fail, die als zutreffend bestätigt wurden und ein klares Ergebnis haben, fließen in den Fakten-Score ein.
unknown und error werden nicht heimlich als Fehler gewertet, senken aber Coverage und Confidence.
Wenn zu wenige Belege vorliegen, zeigt GeoScore lieber unzureichende Beweislage an – daran merkt man dann auch ganz gut, dass es an dieser Stelle noch einige Baustellen gibt.
In 2.4 kam ein Deckelungsmechanismus für schwere Fehler hinzu.
Ein einzelner Critical-Fehler drückt die Höchstpunktzahl der jeweiligen Kategorie auf 49; jeder weitere Critical-Fehler zieht noch einmal 10 Punkte ab, bis hinunter auf mindestens 19.
Ein einzelner Major-Fehler drückt die Obergrenze auf 79; jeder weitere Major-Fehler zieht ebenfalls 10 Punkte ab, bis mindestens 49.
Minor-Fehler wiegen leichter, sollten aber auch nicht völlig ignoriert werden.
Diese Regel soll verhindern, dass eine kaputte Seite, die durch noindex blockiert wird, nicht gecrawlt werden kann oder deren Haupttext sich nicht extrahieren lässt, nur wegen ordentlicher Bild-Alt-Texte und Open-Graph-Tags einen scheinbar beruhigenden Highscore-Bericht bekommt.
Deshalb ist meine Reihenfolge beim Lesen der Ergebnisse inzwischen ziemlich stur: Erst schaue ich auf schwere Fehler und Belege, dann auf Coverage und Confidence und erst ganz zum Schluss auf die Gesamtpunktzahl.
Wie 73 echte Websites zur Kalibrierung beitragen
Ich wollte nicht nur mit meinem eigenen Blog beweisen, dass die Klassifizierung stimmt, also pflege ich inzwischen eine Typ-Kalibrierungsmatrix mit 73 Websites.
Darin stecken Nachrichtenportale, persönliche Blogs, Portfolios, Dokumentationsseiten, Open-Source-Projekte, E-Commerce-Shops, Communities, SaaS-Angebote, professionelle Dienstleister, lokale Unternehmen, Non-Profits sowie Regierungs- und Universitätsseiten.
Für jede Website wird zuerst der zulässige Typbereich festgelegt, danach ruft der aktuelle Code sie eigenständig ab und ordnet sie ein.
Die letzten beiden Durchläufe ergaben einmal 48 Treffer, 0 Fälle zur manuellen Prüfung und 25 nicht erreichbare Seiten sowie einmal 47 Treffer, 0 Fälle zur manuellen Prüfung und 26 nicht erreichbare Seiten.
Der Unterschied von einer Website zwischen beiden Läufen lag an der realen Netzwerkerreichbarkeit und nicht an einem neu aufgetretenen Klassifizierungskonflikt.
Alle erfolgreich abgerufenen und bewerteten Stichproben landeten innerhalb des vorab erlaubten Typbereichs.
Nicht erreichbar bedeutet meist WAF, regionale Sperren, Netzwerkfehler oder Verifizierungsseiten – das zählt weder als bestandene noch als fehlgeschlagene Klassifizierung.
Diese 25 Seiten bleiben bewusst in der Matrix, weil genau solche unkooperativen Seiten das sind, womit ein Audit-Tool in der Praxis klarkommen muss.
Die Bewertung selbst wird zusätzlich mit goldenen HTML-Fixtures kalibriert.
Persönliche Blogs, SaaS, E-Commerce, lokale Unternehmen, Medien und unbekannte Websites haben jeweils feste Belege und Punktebereiche; auch für die Deckelung bei schweren Fehlern gibt es eigene Regressionstests.
Die Matrix echter Websites deckt Verzerrungen bei der Klassifizierung auf, die goldenen Fixtures sorgen für reproduzierbare Punktänderungen – diese beiden Dinge darf man nicht zu einer hübschen Erfolgsquote zusammenrühren.
Website-Modus und Einzel-URL-Modus
GeoScore lässt sich auf zwei Arten nutzen.
Gibt man eine Domain ein, startet der Website-Modus, der bis zu fünf repräsentative HTML-Seiten zieht.
Zuerst wird die Startseite geladen; findet sich eine About-Seite, kommt sie mit dazu, und aus der Sitemap oder den internen Links der Startseite werden nach Pfadtyp weitere Stichproben ausgewählt.
Fünf Seiten sind kein Voll-Crawler der gesamten Website, sondern halten ein Audit in einem nachvollziehbaren und wiederholbaren Rahmen.
Deshalb lohnt sich ein Blick auf die Stichprobenliste im Bericht: Sie zeigt, aus welchen Seiten die aktuellen Schlussfolgerungen überhaupt stammen.
Wenn ich nur einen neuen Artikel, eine frisch überarbeitete Landingpage oder eine bestimmte Themenseite prüfen möchte, kann ich die vollständige URL einfügen.
Dann startet der Einzel-URL-Modus, der gezielt die Zielseite auditiert.
Ist die Zielseite nicht die Startseite, liest das Tool bei Bedarf trotzdem die Startseite mit ein, um Kontext aufzubauen – damit nicht schon ein einziger Artikel über KI dazu führt, dass die ganze Website als SaaS eingestuft wird.
Ich lasse meistens erst die Domain durchlaufen, um globale Einstellungen und das Website-Profil zu prüfen, und schicke danach die Seiten, an denen ich wirklich schrauben will, noch einmal einzeln durch den Einzel-URL-Modus.
Erst prüfen, als was dich das Tool erkannt hat
Nach dem Audit sollte man nicht sofort auf die Gesamtpunktzahl starren.
Schau dir zuerst das Website-Profil an:
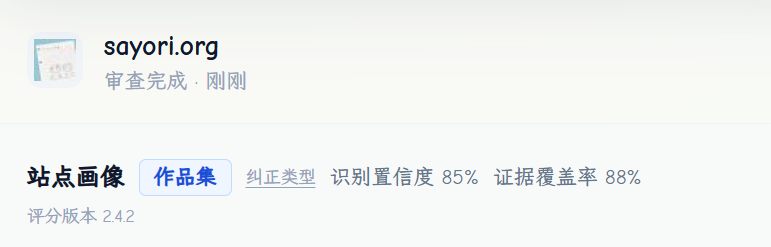
Hier stehen Website-Typ, Entität, Sprache, Root-Domain, gezogene Stichprobenseiten, Erkennungs-Confidence und die Belege für die Klassifizierung.
Das Profil stützt sich bevorzugt auf JSON-LD, Canonical, Titel, Navigation und Seitenstruktur; Keywords im Fließtext zählen nur als schwaches Signal.
Das soll verhindern, dass persönliche Blogs als SaaS eingestuft werden, Dokumentationsseiten als Onlineshops landen und Artikelseiten kommerzielle Schemas aufgezwungen bekommen.
Falls der Typ tatsächlich danebenliegt, kann man für genau dieses eine Audit einen Typ-Hinweis geben, auf Typ korrigieren klicken und den passenden Typ auswählen.
Das schreibt keine dauerhafte Regel ins Gesamtsystem und beeinflusst auch keine anderen Websites.
Warum bei nicht abrufbaren Seiten nicht einfach weitergerechnet werden darf
Echte Websites liefern oft nicht direkt ihren eigentlichen Inhalt aus.
Manche Seiten schicken eine Cloudflare-Challenge vorweg, andere eine Login- oder Consent-Seite, und SiteGround liefert unter Umständen sogar mit HTTP 202 eine /.well-known/sgcaptcha/-Verifizierungsseite aus.
Diese Seiten sehen zwar auch nach HTML aus, aber ein SEO-Audit darauf ergibt bloß einen Scheinbericht über eine Verifizierungsseite.
2.4.5 erkennt solche Zwischenseiten jetzt vorab und wertet HTTP 202 oder leere Verifizierungsseiten nicht mehr als erfolgreichen Abruf.
Wenn der normale HTTP-Abruf auf eine Challenge, einen wiederholbaren Netzwerkfehler oder eine leere JavaScript-Hülle stößt, darf die Startseite einmalig auf Cloudflare Browser Run als Fallback zurückgreifen.
Für diesen Versuch gilt ein festes Budget von 20 Sekunden.
Die Seitennavigation darf höchstens 16,5 Sekunden beanspruchen, nach dem load-Event gibt es noch 1,5 Sekunden für normale Hydration, und die letzten 2 Sekunden sind für das Auslesen des HTML reserviert.
Früher, als noch networkidle2 verwendet wurde, konnten Analyse-Skripte und laufende Requests dafür sorgen, dass die Seite nie auf Netzwerk-Idle kam und das gesamte Zeitbudget auffraß.
Jetzt wird nicht mehr gewartet, bis im Hintergrund völlige Funkstille herrscht, aber es wird weiterhin geprüft, ob das gerenderte Ergebnis eine Challenge, eine Fehlerseite oder eine JavaScript-Hülle ohne Haupttext ist.
Schlägt auch der Fallback fehl, belässt GeoScore die Seite auf unknown oder error, und die Gesamtpunktzahl kann direkt zu unzureichender Beweislage werden.
Gleichzeitig hebt 2.4.5 den Audit-Cache auf v24 an.
So greift das System nach dem Deployment nicht weiter auf alte Timeout- oder Verifizierungsseiten-Ergebnisse zurück, während der alte Cache nach seiner ursprünglichen TTL ganz normal abläuft.
Wie man die benutzerdefinierte API nutzt
Unter dem Eingabefeld auf der Startseite gibt es ein standardmäßig eingeklapptes Panel für eine benutzerdefinierte API.
Das ist eine optionale Funktion und kommt erst nach dem Fakten-Audit zum Einsatz, um für die Evidence Map eine Antwort-Beobachtung durchzuführen.
Nach Eingabe von API Key, HTTPS Base URL und Model lässt sich die Modellliste abrufen oder ein bekanntes Model direkt von Hand eintragen.
An die Base URL muss /v1/models nicht manuell angehängt werden.
Wenn ich https://api.example.com eintrage, ergänzt GeoScore das automatisch zu https://api.example.com/v1.
Selbst wenn man versehentlich /models oder /chat/completions mit einfügt, geht das Tool vor dem Absenden erst wieder auf den jeweiligen API-Basispfad zurück.
Alle drei Felder müssen zusammen ausgefüllt sein; fehlt eines, wird keine Anfrage gesendet.
Vor dem Start des Audits leert der Browser die Felder wieder – sie landen weder im Browser-Speicher noch in der URL oder im heruntergeladenen Bericht.
Auch serverseitig gelten sie nur als Konfiguration für diese eine Anfrage und werden nach Ende des Audits nicht gespeichert.
Das heißt natürlich nicht, dass man bei Bildschirmaufnahmen oder Livestreams echte Keys zeigen sollte – sensible Daten gehören trotzdem unkenntlich gemacht.
Sobald die Anfrage durch ist, erscheint die neueste API-Antwort direkt oben in der Evidence Map.
Dort sieht man Query, Modell, Status, Zeitpunkt, Laufzeit, Antworttext und Anzahl der Zitate; vollständige Antwort und Quellenangaben lassen sich weiter aufklappen.
Ob die benutzerdefinierte API erfolgreich war oder fehlschlägt, verändert den Fakten-Score nicht.
Ich hebe mir das immer auf, bis ich die Faktenprobleme bereits in einer ersten Runde abgearbeitet habe.
Erst die Probleme der Seite selbst ansehen, danach externe Suche und Antwort-Beobachtung – dreht man die Reihenfolge um, lässt man sich leicht von einem generierten Textstück auf die falsche Fährte locken.
Wofür der Monitoring-Token eigentlich gut ist
Beim Anlegen eines Monitoring-Projekts bekommt man zwei Dinge: eine project ID und einen management token.
Die project ID identifiziert das Projekt, und der Token weist nach, dass man berechtigt ist, das Projekt auszulesen, Queries zu ändern, Snapshots auszuführen, den Verlauf anzusehen, den Token zu rotieren oder das Projekt zu löschen.
Auf dem Server wird nur ein geschützter Hash gespeichert; der Klartext-Token wird nur einmalig beim Erstellen oder Rotieren angezeigt.
Deshalb sollte man ihn direkt nach dem ersten Erhalt in seinen Passwortmanager kopieren.
Beim Wechsel von Browser oder Gerät kann man unter „Bestehendes Monitoring-Projekt verbinden“ project ID und Token eingeben und Queries, Verlauf sowie Projektstatus wieder laden.
Standardmäßig speichert die Seite den Token nicht.
Erst wenn man ausdrücklich auf „Auf diesem Gerät speichern“ klickt, landet er im lokalen Speicher des aktuellen Browsers, und man kann jederzeit wieder auf „Dieses Gerät vergessen“ klicken.
Falls der Token doch einmal in einem Screenshot, Chatverlauf oder öffentlichen Log auftaucht, einfach direkt rotieren – der alte Token wird dann sofort ungültig.
Auf der Docs-Seite gibt es direkt kopierbare curl-Requests und die Dokumentation zur öffentlichen API.
Wie das E-Mail-Monitoring funktioniert
Für ein Monitoring-Projekt kann man eine E-Mail-Adresse hinterlegen und verifizieren.
Nur wenn bereits eine vergleichbare Baseline existiert, die Bewertungs-Version identisch ist, die Coverage ausreicht und sich der Score tatsächlich verändert hat, versucht das System eine Benachrichtigung zu senden.
Beim ersten Durchlauf, bei einer Änderung der Bewertungs-Version oder bei unzureichender Beweislage wird nur ein Snapshot gespeichert, ohne künstliche Auf-und-Ab-Warnungen auszulösen.
Der aktuelle E-Mail-Adapter nutzt bevorzugt den primären Versandkanal und kann bei Authentifizierungs-, Rate-Limit-, Netzwerk- oder Upstream-Fehlern auf den eigenen festen Maildienst des Website-Betreibers umschalten.
Unabhängig davon, ob die E-Mail durchgeht, wird der abgeschlossene Audit-Snapshot immer zuerst gespeichert.
Den vollständigen Markdown-Reparaturbericht herunterladen
Nach Abschluss eines Audits lässt sich der vollständige Markdown-Reparaturbericht auf einen Schlag herunterladen, ohne jede Datei einzeln erzeugen zu müssen.
Der Bericht enthält Website-Profil, Stichprobenseiten, Punktzahl samt Deckelungsgründen, alle Fehlerbelege, unbekannte Punkte und externe Fehler, den Status optionaler Module, gruppierte Reparaturaufgaben und Schritte zur Nachprüfung.
Ganz am Ende des Berichts steht außerdem ein Handoff-Prompt für eine Entwicklungs-KI.
Den kann man Codex, Claude oder einem anderen Coding-Assistenten geben, wobei das Modell ausdrücklich angewiesen wird, nur vorhandene Belege zu verwenden und keine nicht existierenden Preise, Dienstleistungen, Adressen, Entitäten, Autoren oder Statistikquellen zu erfinden.
Ich lege diese Markdown-Datei meist direkt neben das Code-Repository der Website, lasse den Coding-Assistenten erst die Quelldateien heraussuchen, die die jeweiligen URLs erzeugen, und prüfe den Diff anschließend selbst.
Eine praxiserprobte Reihenfolge für den Einsatz
- https://geo.sayori.org,先用站点模式审首页域名 öffnen
- Prüfen, ob Website-Profil und Stichprobenseiten nicht danebenliegen
- Wenn gleich oben ein Abruffehler angezeigt wird, zuerst die Belege zur Seitenabfrage ansehen und nicht weiter eine Punktzahl interpretieren, die gar nicht existiert
- Auf Coverage, Confidence und die drei priorisierten Maßnahmen schauen und erst dann entscheiden, ob die Gesamtpunktzahl überhaupt Aussagekraft hat
- Zuerst Critical- und Major-Fehler beheben und direkt in den Quelldateien oder CMS-Templates der betroffenen Seiten anpassen
- Bei Performance-Problemen gesondert prüfen, ob sowohl für Mobilgeräte als auch für Desktop echte PageSpeed-Daten vorliegen
- Wenn die Faktenprobleme erledigt sind, bei Bedarf die Evidence Map ausführen oder einmalig eine benutzerdefinierte API eintragen
- Den Markdown-Bericht herunterladen, einer Entwicklungs-KI für die zweite Lokalisierungsrunde geben, die Änderungen selbst gegenprüfen und deployen
- Bei Bedarf an dauerhafter Beobachtung ein Monitoring-Projekt anlegen und project ID sowie Token im Passwortmanager sichern
- Bei Unklarheiten zu einem Button oder Endpunkt https://geo.sayori.org/docs öffnen
- Nach dem Deployment dieselbe URL erneut auditieren und prüfen, ob die Fehlerbelege wirklich verschwunden sind
Was das Tool nicht kann
GeoScore ist kein unendlich tief laufender Crawler; fünf Stichprobenseiten können nicht jede einzelne URL repräsentieren.
Es ersetzt auch weder Search Console noch Server-Logs, echte Nutzerdaten oder eine inhaltliche Beurteilung durch Menschen.
Bei Seiten, die hinter einer WAF, einer Login-Schranke, einer Verifizierungsseite oder einer regionalen Sperre hängen, kann der Bericht womöglich nur unknown oder error ausgeben.
In so einem Fall sollte man nicht aus reiner Punktejagd seine Sicherheitsrichtlinien abschalten.
Noch weniger kann es aus dem Nichts bestätigen, dass irgendein Consumer-KI-Produkt deine Website tatsächlich zitiert hat.
Für mich machen genau diese klaren Grenzen den Bericht erst richtig brauchbar.
Ein Audit-Tool sollte sauber trennen, was es weiß und was nicht – den Rest prüft dann eben der Website-Betreiber selbst nach.
Weiterlesen
Wenn die Website noch gar nicht steht, lässt sich mit schlanke Blog-Vorlage starten; Domain, Hosting und Bildspeicher liegen bei mir im Cloudflare Free Tier.
Neben Crawling und Indexierung feile ich auch daran, wie sich die Artikel beim eigentlichen Lesen anfühlen – die Abwägungen dazu stehen im Protokoll zum Blog-Redesign.