
GeoScore 2.4.5:一個站長用來查自己網站到底缺什麼的工具
先說製作原因
之前舊版本的geoscore是別人已經開發好的項目,https://geoscoreapp.pages.dev/,這裏也可以體驗一下,我也嘗試用這個不斷優化我的網站的seo,甚至加了wiki列表的Amiya’s Desk和Amiya_desi來增強geo和seo之類的
不過呢,這個項目到後面也展示出侷限性了,我的個人博客經常會收到加 FAQ、價格表或 Service schema 的建議,可我的站既沒有套餐,也不接項目
正好反正我也不缺AI額度,既然自己有需求,那就二開繼續開發試試看吧,這次就肯定要把分類做好了,作爲一個個人博客站點,感覺這種FAQ價格表和Service schema確實是沒必要的
GeoScore 就是在原作者的基礎上二次開發出來的,https://github.com/sprawf/geoscore,原版的GeoScore是Mit協議,所以我也選擇繼承了這個
它是 MIT 協議的開源 SEO 與 GEO 審計工具,入口和源碼都在這裏
https://github.com/Amiyadesi/geoscore
完整的中英文使用文檔在這裏
它的工作是把已經發現的問題、還不知道的問題和根本不適用的問題分開,再把能複驗的修改路徑留給站長,把修改結論能夠生成md文檔餵給AI進行鍼對性增強
2.4.5 的核心還是先分清結論和猜測
每條事實檢查只有五種狀態
| 狀態 | 含義 |
|---|---|
pass | 已經從頁面或響應裏確認通過 |
fail | 有明確證據說明需要處理 |
not_applicable | 這項規則不適合當前站點或頁面 |
unknown | 現在沒有足夠證據判斷 |
error | 抓取或外部服務出了問題 |
只有確認適用並且有結論的 pass 與 fail 會進入事實分
unknown 和 error 不會被偷換成失敗項,但它們會降低 coverage 與 confidence
證據太少時,GeoScore 寧可顯示證據不足,其實也就能看出來這方面是有很多不足了
2.4 增加了嚴重失敗封頂機制
一個 critical 失敗會把對應類別的最高分壓到 49,額外每多一個 critical 再降 10,最低到 19
一個 major 失敗會把上限壓到 79,額外每多一個 major 再降 10,最低到 49
minor 失敗的影響更輕,但也不能完全被忽略
這條規則是爲了防止一個被 noindex、無法抓取或正文不可提取的問題站,因爲圖片 alt 和 Open Graph 做得不錯就拿到一張看似安全的高分報告
所以我現在看結果的順序很死板:先看嚴重失敗和證據,再看 coverage 與 confidence,最後纔看總分
73 個真實站點是怎麼參與校準的
我不想只拿自己的博客證明分類準確,所以現在維護了一份 73 站類型校準矩陣
裏面有新聞媒體、個人博客、作品集、文檔站、開源項目、電商、社區、SaaS、專業服務、本地業務、非營利組織、政府和大學站點
每個站點先寫出可以接受的類型範圍,再讓當前代碼獨立抓取和判斷
最近兩次運行分別得到 48 個匹配、0 個需要人工複覈、25 個不可用,以及 47 個匹配、0 個需要人工複覈、26 個不可用
兩次結果相差一個站點,變化來自真實網絡可用性,而不是新增了一例分類衝突
所有成功抓取並完成判斷的樣本都落在預先允許的類型範圍內
不可用通常來自 WAF、地區限制、網絡錯誤或驗證頁,它不代表分類通過,也不代表分類失敗
這 25 個站點會保留在矩陣裏,因爲審計工具真正需要面對的就是這些不配合的頁面
評分本身另外使用黃金 HTML fixture 校準
個人博客、SaaS、電商、本地業務、媒體和未知站點都有固定證據與分數區間,嚴重失敗封頂也有獨立迴歸測試
真實站點矩陣負責發現分類偏差,黃金 fixture 負責讓分數變化可重複,這兩件事不能混成一個好看的成功率
站點模式和單 URL 模式
GeoScore 有兩種用法
填域名會進入站點模式,它最多抽取五個有代表性的 HTML 頁面
首頁會先被讀取,能發現 About 頁面時會一起加入,再從 sitemap 或首頁內部鏈接裏按路徑類型選出其他樣本
五頁不是全站爬蟲,它只是把一次審計控制在可解釋、可復跑的範圍裏
所以報告裏的樣本列表值得看,它告訴你這一次結論到底來自哪幾頁
如果我只想檢查一篇新文章、剛改完的落地頁或某個專題頁,可以粘貼完整 URL
這會進入單 URL 模式,重點審目標頁
目標頁不是首頁時,工具仍會在需要時讀取首頁建立上下文,避免僅憑一篇寫 AI 的文章就把整站當成 SaaS
我一般先跑域名,確認全站公共配置和站點畫像,再對真正要改的頁面跑一遍單 URL
先確認它把你認成了什麼
審計完成後,不要馬上盯總分
先看站點畫像
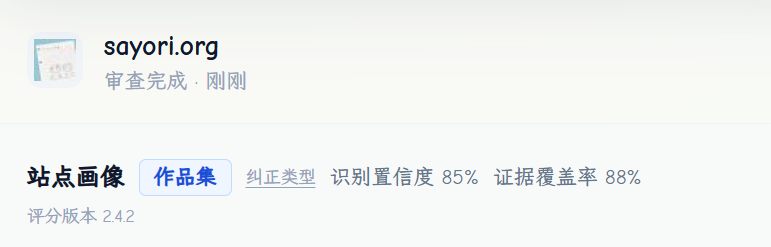
這裏會顯示站點類型、實體、語言、根域名、抽樣頁面、識別置信度和分類證據
畫像優先依據 JSON-LD、canonical、標題、導航和頁面結構,正文關鍵詞只能當弱信號
這是爲了避免個人博客被判成 SaaS,文檔站被判成電商,文章站被強塞商業 schema
類型確實不對時,可以只爲這一次審計給出類型提示,點擊糾正類型選擇正確的類型
它不等於給整個系統寫一條永久規則,也不會影響其他網站
頁面抓不到時,爲什麼不能繼續硬算
真實網站經常不會直接返回正文
有些站會返回 Cloudflare challenge,有些會返回登錄或同意頁面,SiteGround 還可能用 HTTP 202 返回 /.well-known/sgcaptcha/ 驗證頁
這些頁面看起來也是 HTML,但拿它們做 SEO 審計只會得到一份關於驗證頁的假報告
2.4.5 會先識別這些中間頁,不再把 HTTP 202 或空驗證頁當成抓取成功
普通 HTTP 確認遇到 challenge、可重試網絡錯誤或 JavaScript 空殼時,首頁可以使用一次 Cloudflare Browser Run 兜底
這次嘗試有明確的 20 秒預算
頁面導航最多使用 16.5 秒,load 事件後再給 1.5 秒完成普通 hydration,最後保留 2 秒抓取 HTML
之前使用 networkidle2 時,分析腳本和持續請求可能讓頁面一直等不到網絡空閒,最後把整次預算耗完
現在不再等待後臺網絡完全安靜,但仍會檢查渲染結果是不是 challenge、錯誤頁或沒有正文的 JavaScript 空殼
兜底仍然失敗時,GeoScore 會把頁面留在 unknown 或 error,總分可以直接變成證據不足
2.4.5 同時把審計緩存提升到 v24
這樣部署後不會繼續命中舊版本留下的超時或驗證頁結果,舊緩存會按原來的 TTL 自然過期
自定義 API 要怎麼用
首頁輸入框下面有一個默認收起的自定義 API 面板
這是可選功能,只在事實審計完成後,爲 Evidence Map 做一次回答觀察時使用
填入 API Key、HTTPS Base URL 和 model 後,可以拉取模型列表,也可以直接手動填寫一個已知 model
Base URL 不需要手動拼 /v1/models
如果我填的是 https://api.example.com,GeoScore 會自動補成 https://api.example.com/v1
誤把 /models 或 /chat/completions 一起粘貼進去時,它也會先退回對應 API 根路徑再發請求
三個字段需要一起填寫,缺一個就不能發出請求
開始審計前,瀏覽器會清空它們,它們不會寫入瀏覽器存儲、URL 或下載報告
服務端也只把它們當作一次請求的配置,審計結束後不會持久化
這不意味着可以在錄屏或直播裏展示真實 Key,敏感信息還是應該遮掉
請求完成後,最新 API 回答會直接顯示在 Evidence Map 頂部
這裏能看到查詢、模型、狀態、時間、耗時、回答正文和引用數量,完整回答與引用可以繼續展開
自定義 API 成功或失敗,都不會改動事實評分
我會把它留到事實問題已經處理過一輪以後再用
先看頁面本身的問題,再看外部搜索和回答觀察,順序反過來很容易被一段生成文本帶偏
監控 Token 到底有什麼用
創建監控項目後會拿到兩樣東西:project ID 和 management token
project ID 用來標識項目,Token 用來證明你有權讀取項目、修改查詢、運行快照、查看歷史、輪換 Token 或刪除項目
服務端只保存經過保護的哈希,原始 Token 只會在創建或輪換時顯示一次
所以第一次拿到後應該先複製到自己的密碼管理器
換瀏覽器或換設備時,可以在“連接已有監控項目”裏填入 project ID 和 Token,把查詢、歷史與項目狀態重新加載回來
頁面默認不會保存 Token
只有明確點擊保存到本設備後,它纔會進入當前瀏覽器的本地存儲,也可以隨時點忘記本設備
如果 Token 出現在截圖、聊天記錄或公開日誌裏,直接輪換,舊 Token 會立即失效
Docs 頁面給出了可以直接複製的 curl 請求和公開 API 說明
郵件監控怎樣工作
監控項目可以填寫郵箱並完成驗證
只有建立過可比較的基線、評分版本相同、coverage 足夠並且分數真的發生變化時,系統纔會嘗試發送提醒
第一次運行、評分版本變化或證據不足時只保存快照,不製造漲跌告警
當前郵件適配器優先使用主發信通道,鑑權、限流、網絡或上游故障時可以切到站長自己的固定發件服務
無論郵件是否成功,已經完成的審計快照都會先保存下來
下載完整 Markdown 修復報告
跑完審計後,可以一次下載完整 Markdown 修復報告,不需要逐項生成文件
報告會帶上站點畫像、抽樣頁面、評分與封頂原因、全部失敗證據、未知與外部錯誤、可選模塊狀態、分組修復任務和複驗步驟
報告最後還有一段給開發 AI 的 handoff prompt
它可以交給 Codex、Claude 或其他編程助手,但會要求模型只使用已有證據,不能編出不存在的價格、服務、地址、實體、作者或統計來源
我通常把這份 Markdown 放在網站代碼倉庫旁邊,讓編程助手先定位生成對應 URL 的源文件,再自己審查 diff
一套實際使用順序
- 打開 https://geo.sayori.org,先用站點模式審首頁域名
- 確認站點畫像和抽樣頁面沒有跑偏
- 如果首屏顯示抓取失敗,先看頁面獲取證據,不要繼續解釋一個不存在的分數
- 看 coverage、confidence 與三個優先行動,再決定總分有沒有參考價值
- 先處理 critical 與 major 失敗,回到對應頁面的源文件或 CMS 模板改
- 性能問題單獨確認移動端和桌面端都有真實 PageSpeed 數據
- 事實問題處理完,再按需運行 Evidence Map 或填一次自定義 API
- 下載 Markdown 報告,交給開發 AI 做第二輪定位,自己審覈改動後部署
- 需要持續觀察時再創建監控項目,並把 project ID 和 Token 保存到密碼管理器
- 不清楚某個按鈕或接口時打開 https://geo.sayori.org/docs
- 部署後重新審計同一 URL,確認失敗證據真的消失
它做不到什麼
GeoScore 不是無限深度爬蟲,五頁樣本不能代表每一個 URL
它也不會替代 Search Console、服務器日誌、真實用戶數據或人工內容判斷
被 WAF、登錄牆、驗證頁或地區限制擋住的頁面,報告可能只能給出 unknown 或 error
這時不應該爲了追分關閉安全策略
它更不可能憑空確認某個消費者 AI 產品真的引用了你的站
對我來說,這些邊界反而讓報告更能用
一個審計工具應該把知道什麼、不知道什麼說清楚,剩下的事情再交給站點維護者去驗證
部分資訊可能已經過時